文章 · 2026-10-21
示例:一篇研究笔记的排版结构
这条是占位内容,目的不是讲延迟,而是让你看清一篇长文在这套版式里长什么样: 标题层级、摘要、图、公式化的代码、表格、引用和附件区。
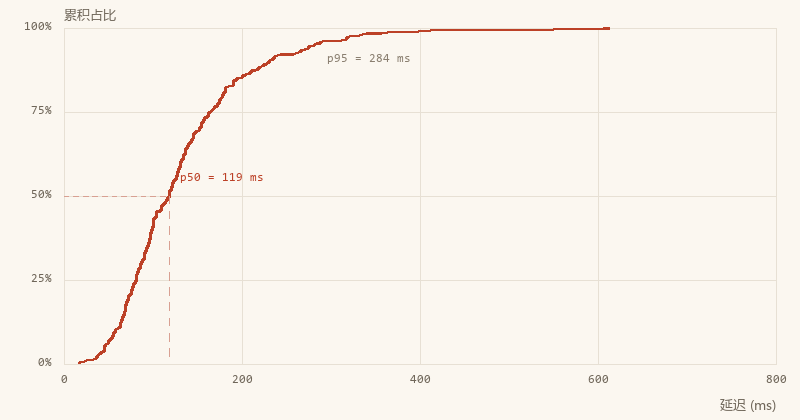
摘要。用一个 400 条请求的样本,说明为什么平均值会误导人: 均值 148 ms 看起来还不错,但 p95 已经到 284 ms,也就是每 20 次访问就有一次比均值慢一倍。 文末给出原始数据和作图用的脚本。
为什么要看分位数
延迟分布是典型的长尾:大部分请求很快,少数请求慢得离谱。平均值被长尾拉高, 同时又把"大多数人体验到的速度"掩盖掉。把累积分布画出来,一眼就能看到 "有多少比例的请求快于某个阈值"。
这套版式支持常见的写作元素:加粗、行内代码、
页内锚点、脚注式的括号说明(例如 p95 的定义),
以及下面这种列表:
- 均值适合做容量规划,不适合描述体验;
- p50 描述"典型用户",p95 / p99 描述"最差的那部分";
- 样本量小于几百时,p99 的估计会很不稳定。
采样与清洗
样本来自 400 次请求,剔除了状态码非 200 的 17 条,未做截尾处理。 时间窗口是一个连续的 10 分钟。
计算分位数
最省事的做法是排序后按位置取。下面这段是当时用的脚本,没有依赖,直接跑:
import csv

lat = sorted(
    int(r["latency_ms"])
    for r in csv.DictReader(open("demo-data.csv"))
    if r["status"] == "200"
)

def q(p):
    return lat[min(len(lat) - 1, int(len(lat) * p))]

print(q(0.50), q(0.95), q(0.99))
结果
三个分位数放在一起,差别比想象中大:
| 指标 | 数值 | 含义 |
|---|---|---|
| 均值 | 148 ms | 被长尾拉高,参考价值有限 |
| p50 | 119 ms | 一半请求快于这个值 |
| p95 | 284 ms | 每 20 次请求有 1 次更慢 |
| p99 | 512 ms | 接近 800 ms 的截断边界,估计不稳 |
如果一个指标不能解释"用户什么时候会觉得卡",那它就不该出现在看板的第一屏。
参考
- 累积分布函数的定义与性质,任何一本概率论教材的第一章。
- 关于长尾分布下均值失效的讨论,见文末附件里的数据,可自行复现。
到这里就是正文的结尾。实际写作时,这一节通常会换成结论、局限或下一步计划。 正文宽度固定在一行约 40 个汉字,长文不容易读串行。